
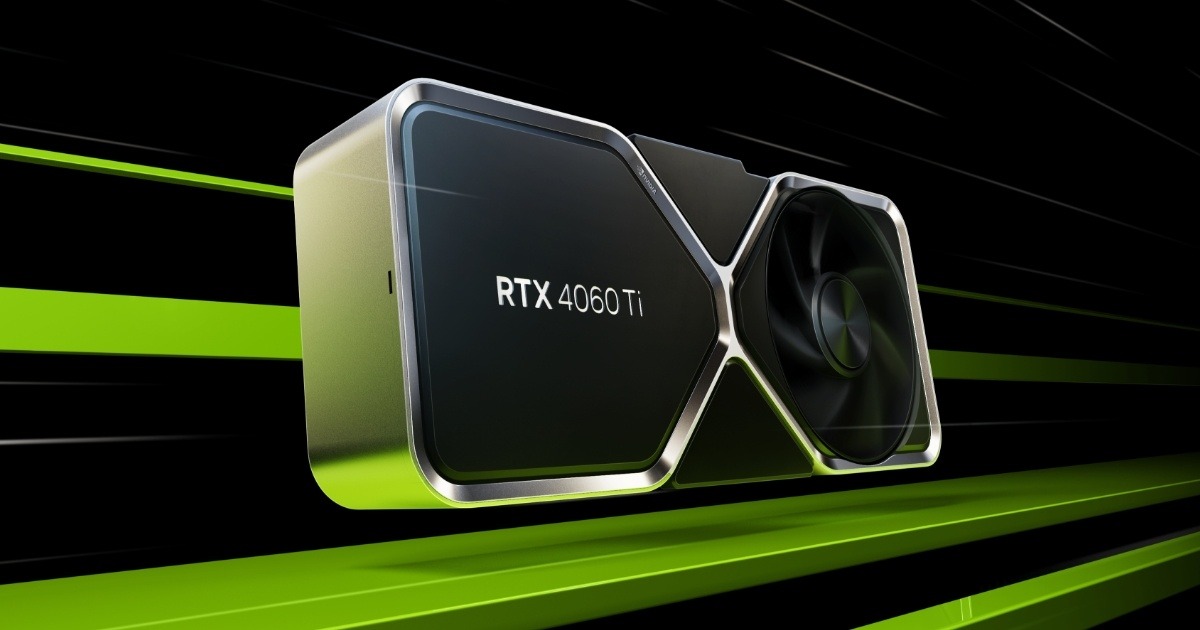
RTX 4060 Ti · 16 GB de VRAM
Use a versão de 16 GB, não a placa de 8 GB. O computador e a RAM do sistema são requisitos adicionais.
- Memória
- 16 GB · VRAM
- Plataforma
- CUDA · host PC
- Banda de memória
- 288 GB/s
Algumas fontes indisponíveis; últimos dados válidos preservados. Consulta do catálogo: 2026-09-26.
Imagem, vídeo e áudio
Requisitos de memória documentados pelos publicadores abaixo desta capacidade. Arquitetura exata da GPU, suporte a ARM64, precisão e runtime ainda precisam de conferência.
- Wan2.1 T2V 1.3B · 8.19 GB · Configuração oficial T2V 1.3B · evidência ↗
Especificações do hardware
- Chip
- Ada Lovelace · RTX 4060 Ti
- Memória física
- 16 GB GDDR6 · 128-bit
- Plataforma de execução
- CUDA · host PC
- Banda de memória
- 288 GB/s · fabricante ↗
A NVIDIA lista uma configuração da RTX 4060 Ti com 16 GB de memória GDDR6 dedicada. Confira abaixo os checkpoints candidatos e suas contagens de parâmetros; reserve espaço adicional para contexto maior, componentes de mídia e sobrecarga do runtime.
Especificações oficiais ↗A banda é uma especificação teórica do hardware, não uma medição de velocidade do modelo. Compatibilidade de runtime e checkpoint precisa ser conferida separadamente.
Fontes, atualizações e estimativa
Candidatos revisados usam contagens publicadas do modelo. Candidatos automáticos usam contagens de tensores em ponto flutuante de repositórios oficiais no Hugging Face, com a revisão da fonte preservada. Pesos quantizados empacotados, arquiteturas não reconhecidas e metadados multimodais ficam fora da estimativa automática. Nenhum desses critérios comprova que existe um checkpoint quantizado ou que ele roda nesta máquina.
A rotina de descoberta adiciona modelos elegíveis sem criar outra página de hardware. A página consulta o catálogo salvo a cada cinco minutos enquanto está visível. Metadados incompletos continuam no catálogo geral; uma falha de atualização preserva os últimos dados válidos.
Planejamento = pesos estimados + 20% de margem de trabalho + cache informado + reserva heurística (8 GB unificados ou 2 GB por GPU dedicada). As reservas são hipóteses de planejamento, não mínimos do fabricante. Tokens de contexto não calculam automaticamente o cache KV.
Catálogo completo de modelos · Dados e metodologia
Especificação de hardware revisada: 2026-09-26. Fontes de modelos e medições têm datas próprias.